

Un agente que contrasta cada cifra con la evidencia, medido con errores plantados
Prueba propia de portfolio, no un trabajo de cliente. El material son los README y los resultados de tres repositorios nuestros (licencia MIT) y nuestros propios logs. Los errores los plantamos nosotros y la verdad de referencia la calcula código, no una persona. Modelo local abierto, sin APIs de pago. Estimaciones marcadas como tales.
El problema
Un informe técnico, un README o un caso de estudio está lleno de cifras: porcentajes, tiempos, versiones, licencias, fechas y frases del tipo «hicimos X». Entre la cifra y el dato original hay copias a mano, redondeos y valores de una versión anterior. Revisarlo a mano cuesta horas, y si a un LLM se le pregunta «¿es verdad?» suele decir que sí. Queríamos un agente que no pueda dar por bueno nada que no sepa señalar con el dedo, y saber con números cuándo merece la pena la parte compleja.
Qué hicimos: tres diseños y una regla
- Recuperación (ronda 1): extractor de afirmaciones (reglas + LLM), recuperador determinista de evidencia (búsqueda, rutas JSON, filas CSV, aritmética que recalcula sumas y ratios), juez LLM con la salida forzada a un esquema y cita obligatoria, y una guarda determinista que degrada a UNVERIFIED cualquier OK sin cita real.
- Solo LLM: el mismo extractor y el mismo modelo, pero con la carpeta de evidencia pegada en el prompt, sin herramientas ni guarda.
- Híbrido v2 (el que publicamos): si los ficheros de evidencia relevantes caben en el presupuesto de contexto (un parámetro), el juez los lee enteros; si no, usa la recuperación. Los dos caminos acaban en la misma guarda: ningún OK sin un fragmento citado que contenga las cifras, ningún MISMATCH sin fragmento citado y valor encontrado.
- El modelo es configurable por variable de entorno (cualquier endpoint compatible con la API de OpenAI). Temperatura 0, semilla fija, y cada llamada queda registrada.
Cómo lo medimos
Banco de pruebas etiquetado, construido y sellado (con hashes) antes de ejecutar la segunda ronda. De cada informe hay una versión limpia y dos con errores plantados de ocho tipos: cifra cambiada, unidad o redondeo, suma o ratio mal calculado, cifras en el sistema equivocado, licencia equivocada, fecha desfasada, afirmación nueva sin evidencia y «hicimos X» sin evidencia. La verdad de referencia sale de código: cada afirmación limpia lleva una comprobación contra los ficheros de evidencia y cada error plantado tiene que fallarla.
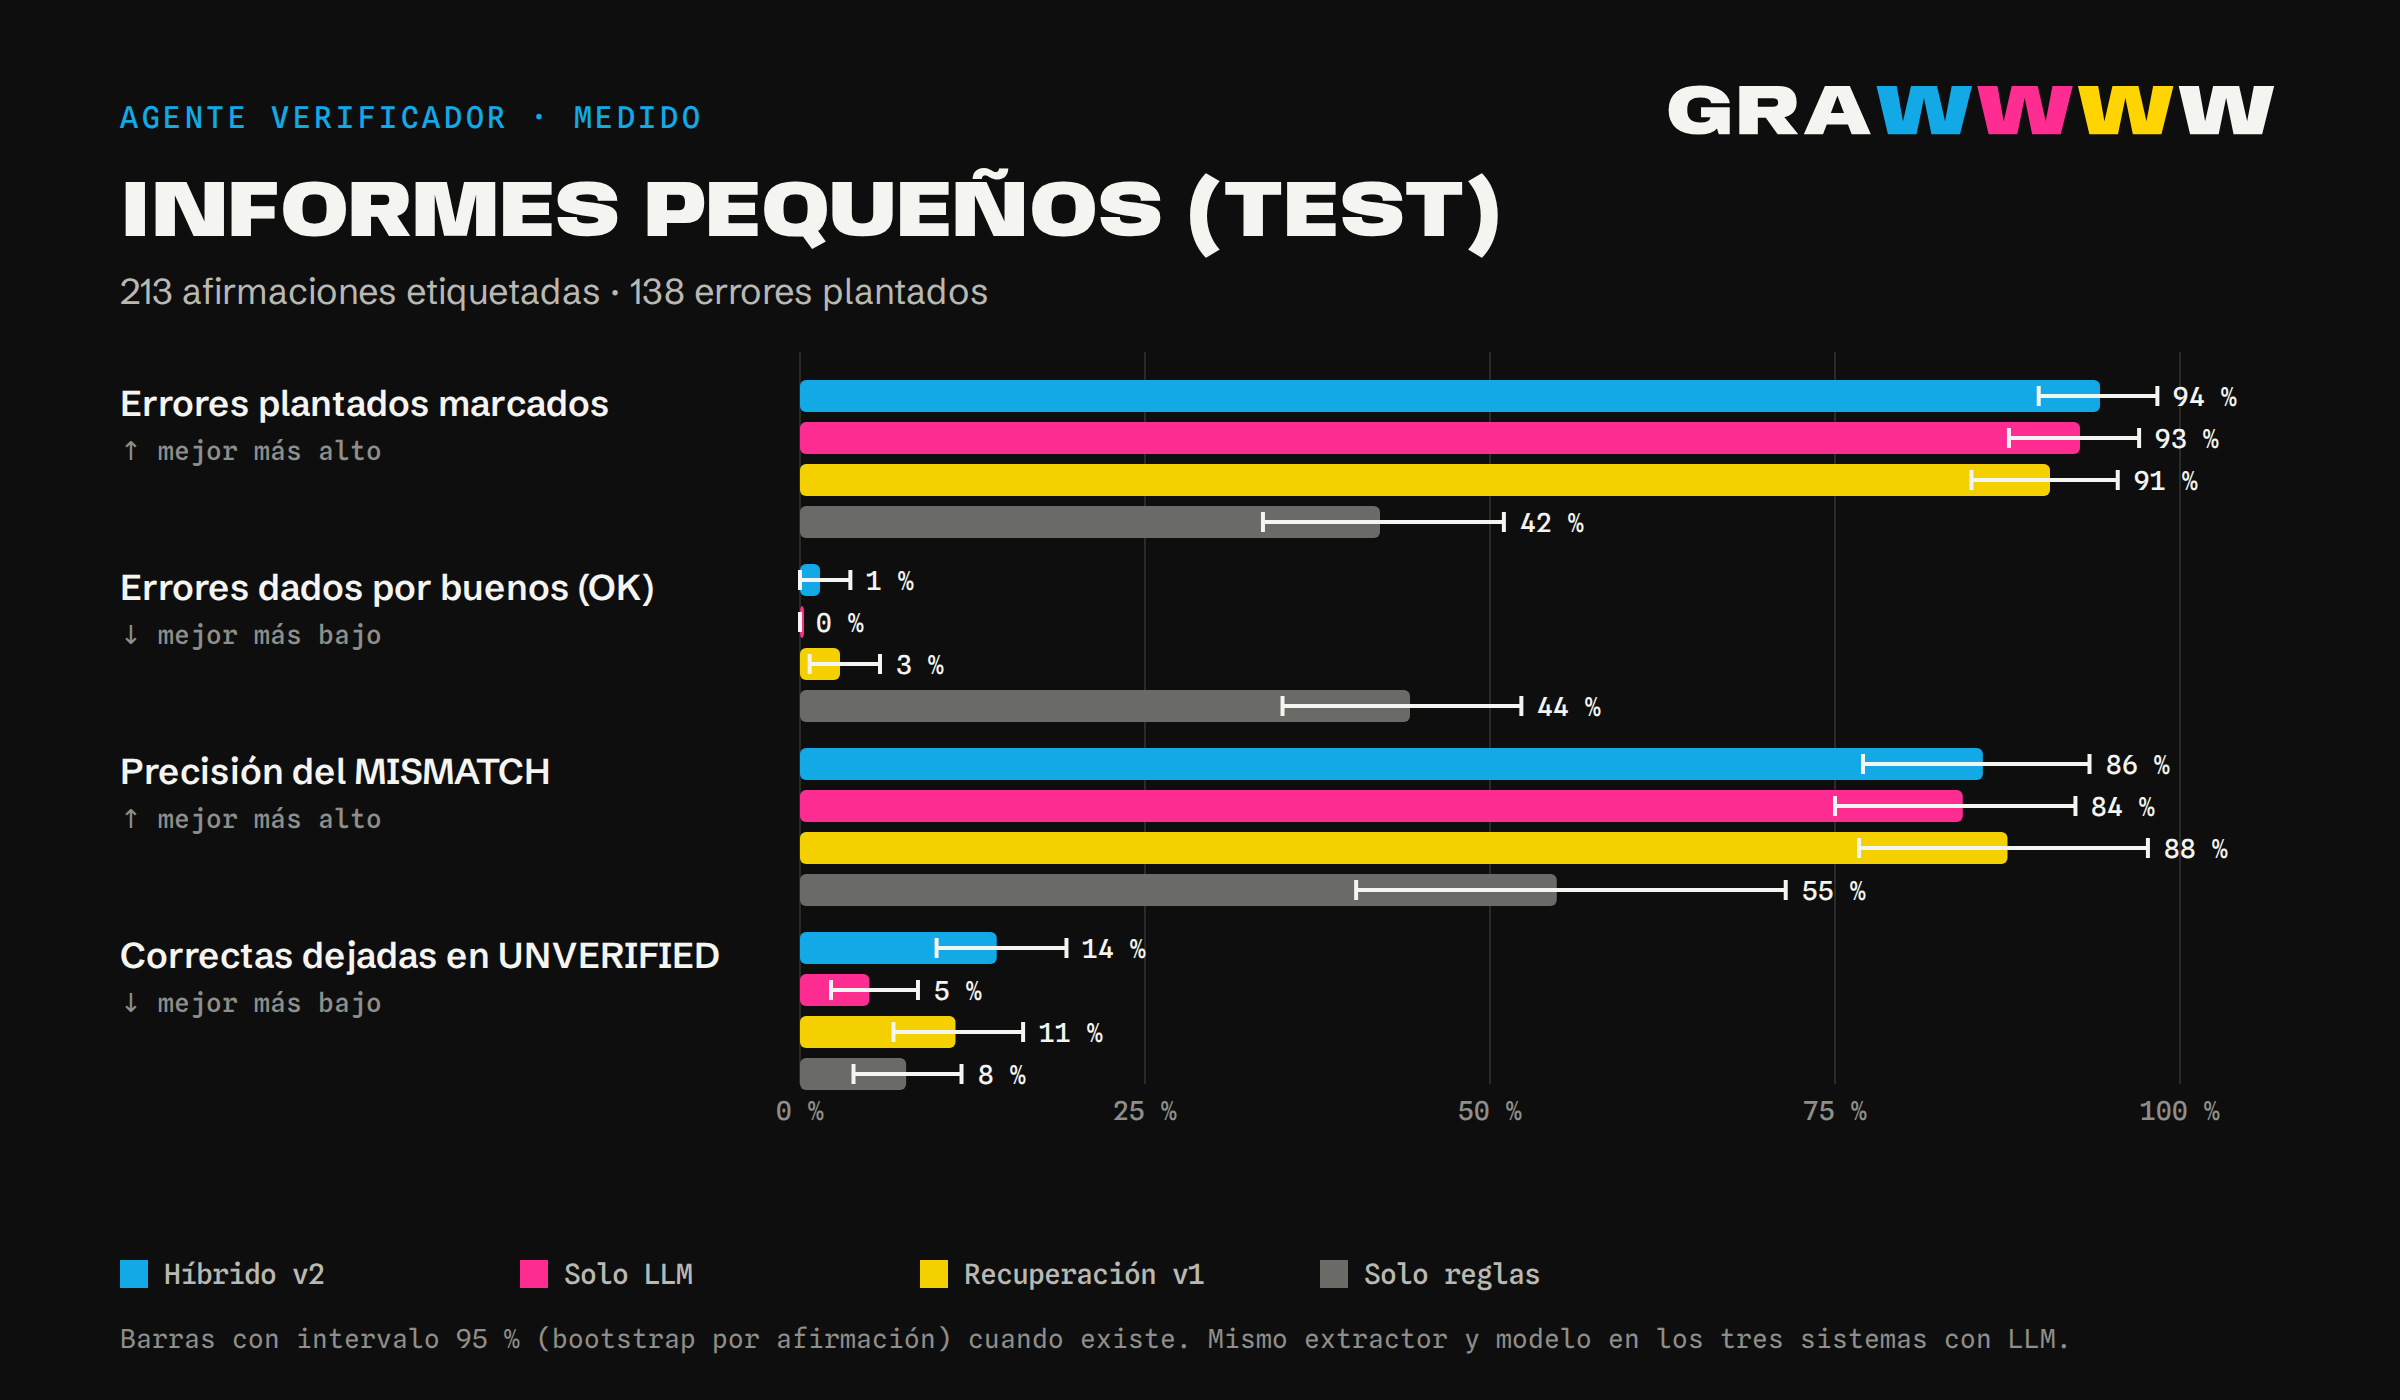
- Informes pequeños (test): 213 afirmaciones etiquetadas en 12 informes, 138 errores plantados, con errores nuevos distintos de los de la primera ronda.
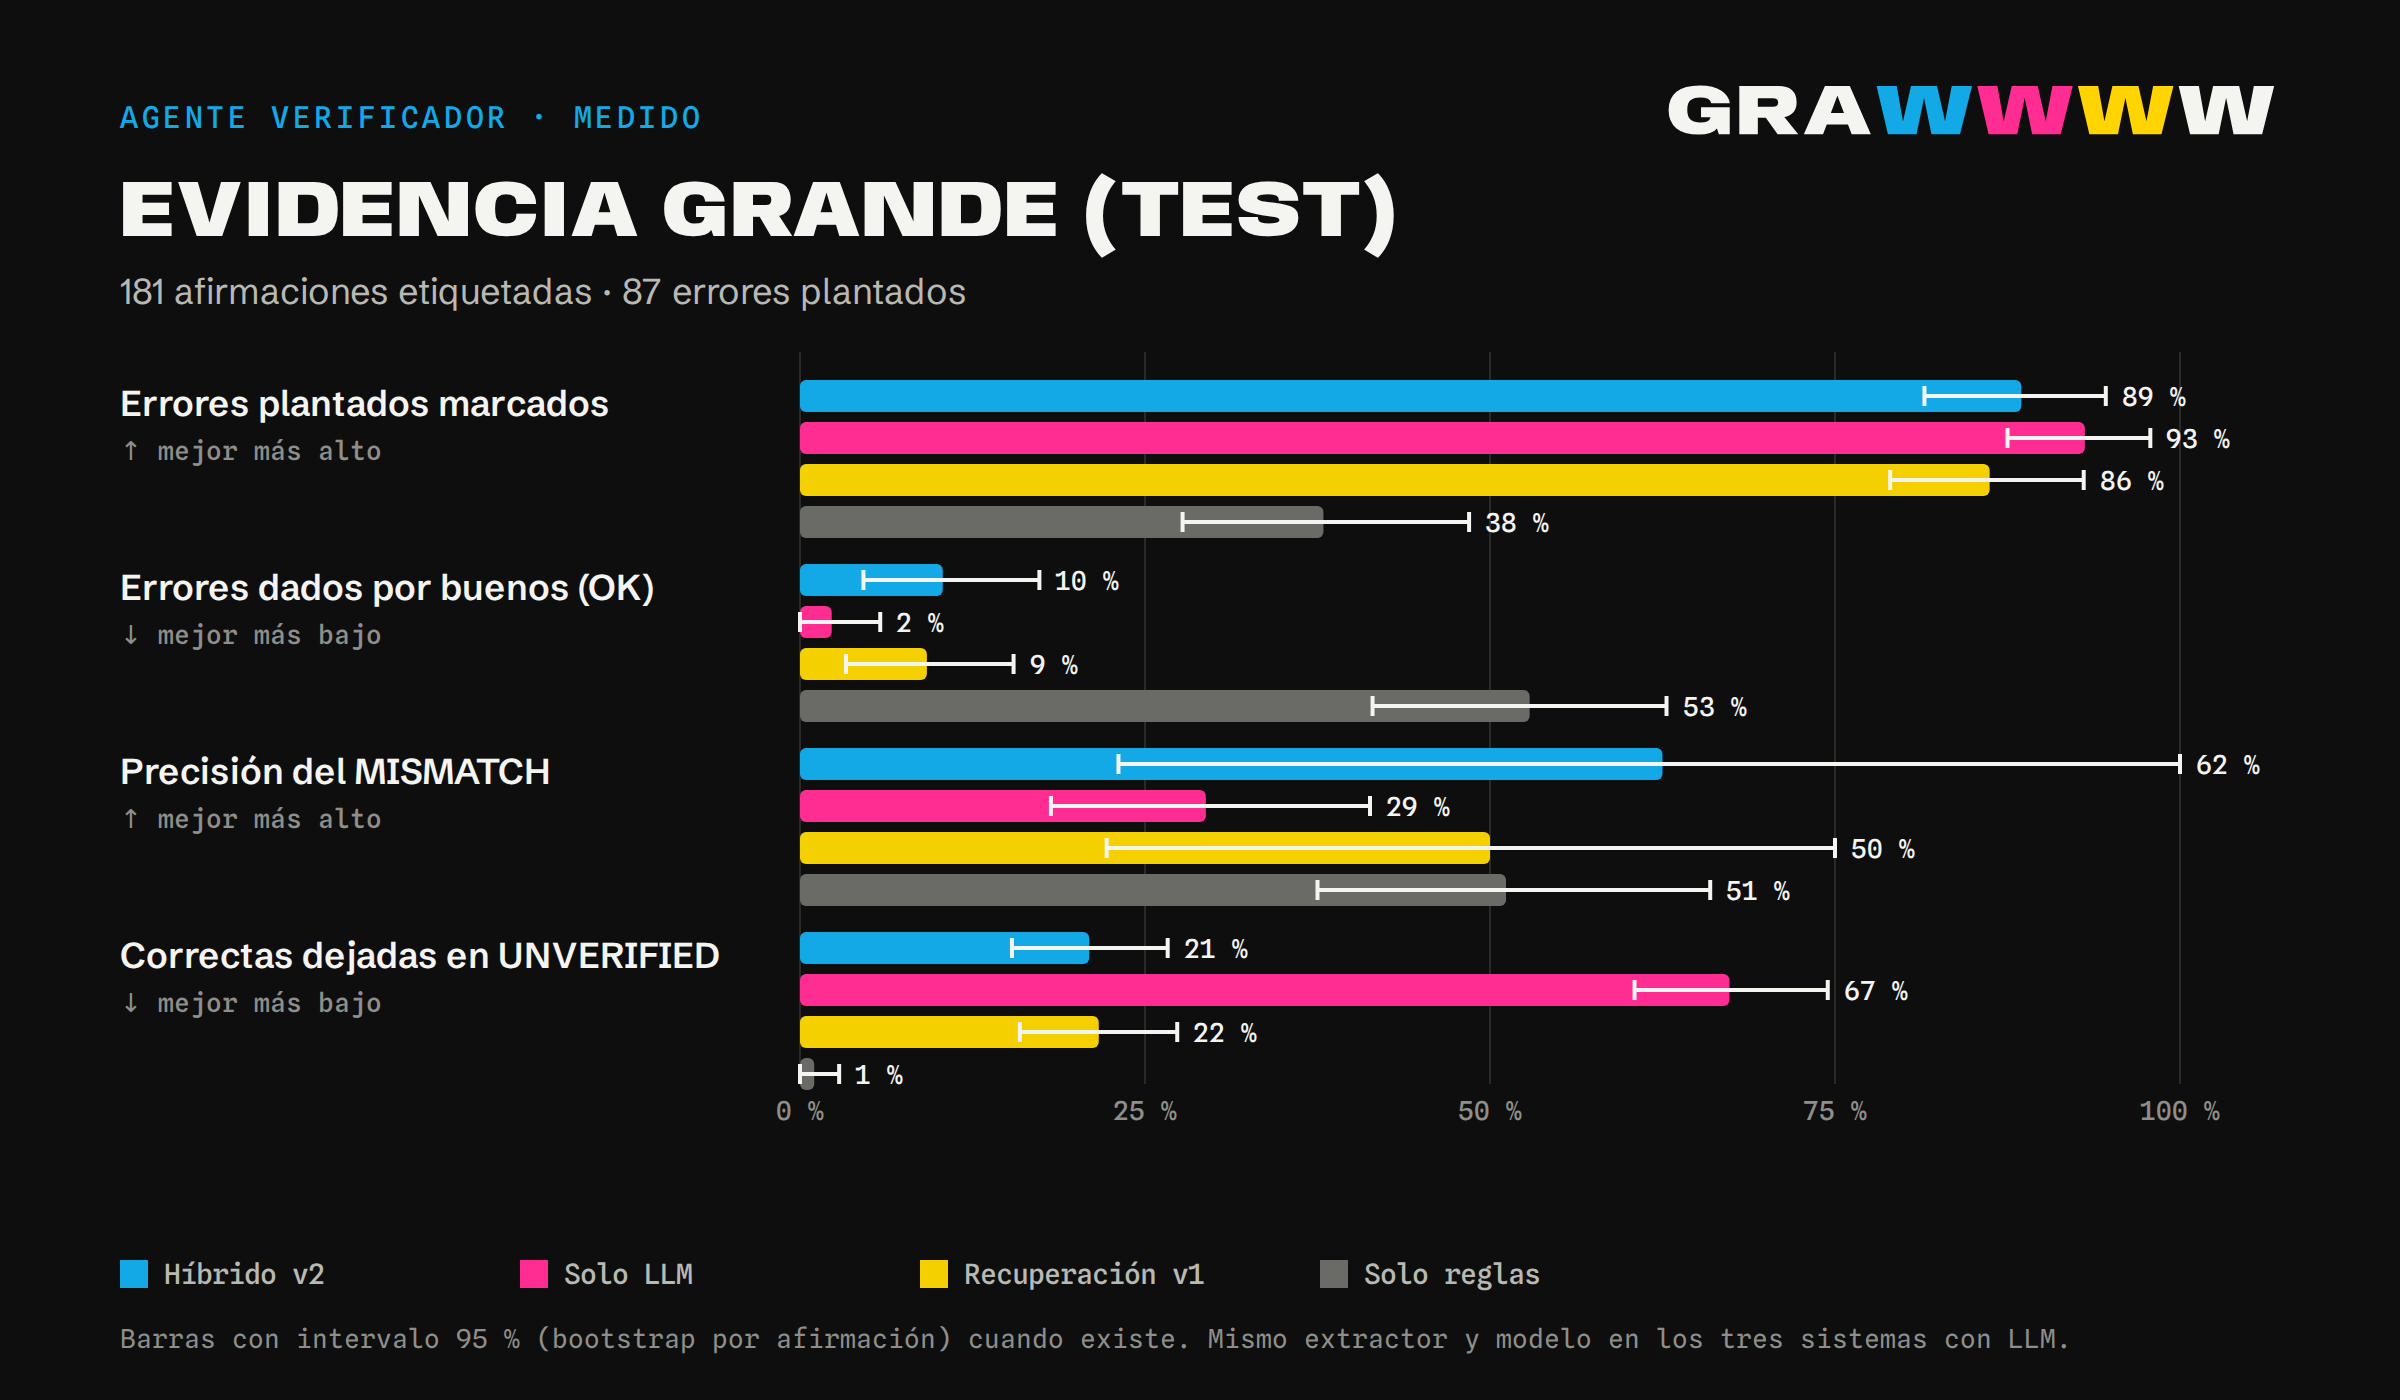
- Evidencia grande (test): 181 afirmaciones en 6 informes, 87 errores plantados, sobre 1,6 MB de logs reales nuestros que no caben en el contexto. Los informes son texto generado con plantilla sobre esos logs: miden la búsqueda profunda, no la prosa.
- Los prompts y la configuración se ajustaron solo con los conjuntos de desarrollo; los de test se ejecutaron una vez, salvo el informe 10 del test pequeño (v2), repetido desde cero tras una caída del servidor del modelo.
Números: informes pequeños
| Sistema | Errores plantados marcados | Errores dados por buenos (OK) | Precisión del MISMATCH | Correctas marcadas MISMATCH | Correctas dejadas en UNVERIFIED | Tiempo por informe | Coste por informe, ESTIMACIÓN |
|---|---|---|---|---|---|---|---|
| Híbrido v2 | 94 % (90–98) | 1 % (0–4) | 86 % (77–93) | 2 % (1–3) | 14 % | 643 s | 0,061 $ |
| Solo LLM | 93 % (88–97) | 0 % (0–0) | 84 % (75–92) | 3 % (1–5) | 5 % | 656 s | 0,062 $ |
| Recuperación v1 | 91 % (85–95) | 3 % (1–6) | 88 % (77–98) | 1 % (0–2) | 11 % | 716 s | 0,068 $ |
| Solo reglas | 42 % (34–51) | 44 % (35–52) | 55 % (40–71) | 4 % (2–8) | 8 % | 4 s | 0,000 $ |
Entre paréntesis, el intervalo del 95 % (bootstrap por afirmación). «Marcados» cuenta como acierto un MISMATCH o un UNVERIFIED sobre un error plantado; «dados por buenos» son los errores que el sistema aceptó como OK. Aquí pegar la evidencia gana o empata: el híbrido marca el 94 % y el solo LLM el 93 %, pero el solo LLM da el veredicto exacto en el 83 % de los 138 errores plantados frente al 63 % y deja el 5 % de las correctas en UNVERIFIED frente al 14 %. De los dos repositorios, solo la evidencia de uno cabe entera; en el otro el solo LLM ve el 41 % y aun así acierta más. No hay motivo para complicarlo mientras la evidencia cabe.
Números: evidencia grande
| Sistema | Errores plantados marcados | Errores dados por buenos (OK) | Precisión del MISMATCH | Correctas marcadas MISMATCH | Correctas dejadas en UNVERIFIED | Tiempo por informe | Coste por informe, ESTIMACIÓN |
|---|---|---|---|---|---|---|---|
| Híbrido v2 | 89 % (81–95) | 10 % (5–17) | 62 % (23–100) | 1 % (0–2) | 21 % | 314 s | 0,030 $ |
| Solo LLM | 93 % (88–98) | 2 % (0–6) | 29 % (18–41) | 12 % (8–17) | 67 % | 245 s | 0,023 $ |
| Recuperación v1 | 86 % (79–93) | 9 % (3–15) | 50 % (22–75) | 2 % (0–3) | 22 % | 330 s | 0,031 $ |
| Solo reglas | 38 % (28–48) | 53 % (41–63) | 51 % (38–66) | 7 % (4–11) | 1 % | 6 s | 0,000 $ |
Aquí el solo LLM ve el 4 % de la evidencia (se trunca) y deja de ser utilizable: precisión del MISMATCH 29 %, 12 % de las correctas marcadas MISMATCH y 67 % dejadas en UNVERIFIED. El híbrido mantiene 62 % de precisión (base pequeña: 8 veredictos MISMATCH), 1 % de falsas alarmas y 21 % en UNVERIFIED. Pero deja pasar el 10 % de los errores plantados como OK (intervalo 5–17 %) frente al 2 % del solo LLM, y el veredicto exacto solo acierta en el 25 % de los errores: suele decir «no consta» en lugar de «está mal».
El coste es parecido entre los tres sistemas con LLM: 0,06–0,07 $ por informe en los informes pequeños y 0,02–0,03 $ con evidencia grande: estimación = segundos × precio listado de RunPod para RTX 4090 (0.34 $/h Community, 0.89 $/h Secure, https://www.runpod.io/pricing, página fechada 2026-10-08, comprobada de nuevo el 2026-10-17). Modelo local en una GPU compartida; el precio cambia.
Un ejemplo de salida
Primeras filas de una ejecución real del híbrido sobre un informe con errores plantados, cada veredicto con la línea que lo prueba.
| Línea | Afirmación | Veredicto | Encontrado | Evidencia |
|---|---|---|---|---|
| 5 | These figures were verified against production telemetry by the operat | UNVERIFIED | ||
| 5 | verified against production telemetry | UNVERIFIED | ||
| 6 | 5000 sentences | OK | test: 5000 | results.json:line 23 |
| 6 | 2314 Wikipedia articles | OK | "test": 2314 | results.json:line 28 |
| 8 | 34.9 MB | UNVERIFIED | ||
| 14 | 74.05 | UNVERIFIED | copy_input letter_accuracy 0.7404 | |
| 14 | [73.88, 74.22] | UNVERIFIED | copy_input CI [0.7387, 0.7422] | |
| 14 | 76.41 | MISMATCH | copy_input syllable_accuracy 0.1892 | results.json:line 49 |
| 14 | [23.40, 19.24] | MISMATCH | [0.18625221763032393, 0.19239586573539172] | results.json:line 55 |
| 14 | 90.11 | OK | results.json:line 54 | |
| 14 | 0.00 | OK | results.json:line 52 | |
| 15 | 93.09 | OK | results.json:line 66 | |
| 15 | [92.98, 93.19] | OK | results.json:line 79 | |
| 15 | 18.93 | MISMATCH | 0.7641301798632534 | results.json:line 69 |
Qué falla y qué no medimos
- Errores plantados que se cuelan como OK: 2 en los informes pequeños y 9 con evidencia grande. Ejemplos reales, con la razón del modelo (en inglés):
0.0013 USD(comfyui-photo-preset, línea 10): Evidence E1 lists max usd_per_image as 0.001336, which rounds to 0.0013.0.09 %(comfyui-photo-preset, línea 117): Classic value matches; preset value is 0.0 in E4.4.066(ltest, línea 35): Evidence E1, E2, E3, E4 all show latency_s=4.066.3.673(ltest, línea 34): Evidence E1 explicitly states latency_s=3.673 for tag judge_llm_only.5.738(ltest, línea 33): Evidence E1 shows latency_s is 5.738 for tag judge.
- Falsas alarmas en los informes pequeños: 8 afirmaciones correctas marcadas MISMATCH, por ejemplo:
0.85(comfyui-photo-preset, línea 26): Evidence states median 0.861, report claims 0.85.$0.89/h(canine-vi-diacritics, línea 48): report says $0.89/h; evidence says price_date 2026-10-16 (results.json)
- El lote de 8 afirmaciones no aceleró nada: con las mismas métricas en desarrollo, el tiempo por informe fue 563 s frente a 561 s en sdev y 345 s frente a 345 s en ldev. Todos los informes de desarrollo usaron la recuperación, así que la ruta «evidencia entera» con lotes se estrenó en el test; 17 de 1941 afirmaciones del test pequeño quedaron en UNVERIFIED porque un lote no devolvió el esquema.
- Qué no medimos: otros modelos (uno, local), otros dominios o idiomas, PDF o imágenes, evidencia de más de 1,6 MB, evidencia más allá de estos dos repositorios pequeños y un conjunto grande, variación entre ejecuciones (una por sistema, salvo el informe repetido). Etiquetamos una muestra de las afirmaciones comprobables, no todas. El agente solo conoce la carpeta de evidencia que le das: no sabe si tus datos están bien, solo si el informe los refleja.
Qué recibe un cliente
Un verificador a medida para tus propios informes: el extractor ajustado a tus formatos, el recuperador conectado a tus carpetas de resultados, logs o hojas de cálculo, la regla «evidencia entera o recuperación» calibrada con tu volumen de datos, el modelo que prefieras (local o de pago, endpoint configurable), una evaluación con un banco de pruebas etiquetado con tus documentos y una lista honesta de lo que falla.
Sistemas de agentes: desde 1.500 €, sin IVA. Es un precio de partida: tras la primera conversación, la propuesta cierra el alcance y el precio. Detalle en Equipos técnicos, o escríbenos a hello@grawwww.xyz. Respondemos en menos de 48 horas.
Créditos y licencias
- Nuestro código, README y resultados: licencia MIT. El banco de pruebas usa copias de los README, informes y ficheros de resultados de nuestros repositorios (MIT) y de nuestros logs; los informes con errores plantados son datos de prueba, no afirmaciones sobre esos proyectos.
- Texto de terceros citado en esos materiales: frases de la Wikipedia en vietnamita (CC BY-SA 4.0 / 3.0 y GFDL, autores en el historial de cada artículo) y la nota MIT de las plantillas de Comfy Org.
- Modelo: un ajuste fino comunitario de Qwen3.8-27B (Alibaba Cloud) del usuario de Hugging Face Jiunsong, ejecutado en local como cuantización Q4_K_M con llama.cpp (MIT). El modelo base y este ajuste se publican bajo Apache-2.0. Su autor redujo el comportamiento de rechazo del modelo; solo lo usamos para leer fragmentos cortos de evidencia y devolver veredictos, y los números del benchmark valen solo para este archivo. No redistribuimos pesos y no tenemos relación con Alibaba Cloud. La revisión exacta, el checksum y las fuentes están en
licences.mddel repositorio.